猛犸设计|达芬奇语音识别插件开发成功!
🎉 猛犸设计|达芬奇语音识别插件开发成功!
✅ 多语种识别 | STT 模型 | 大模型后处理 | Windows 全适配
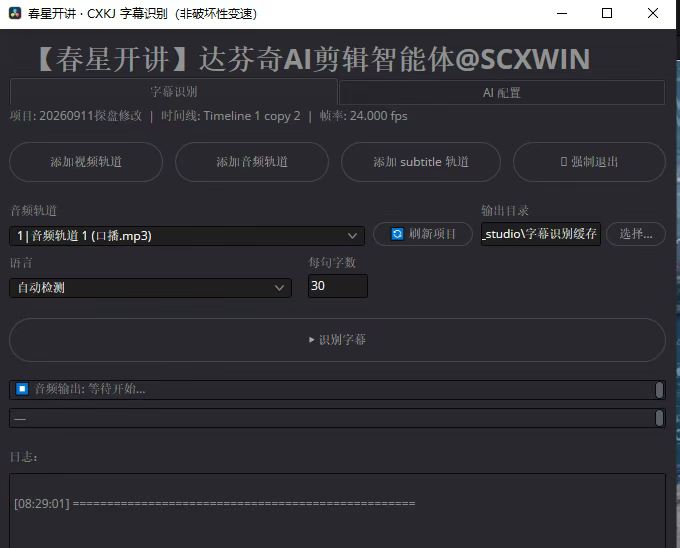
重点优化原版痛点
我们在原开源版本的基础上重点攻坚,断句错乱、字幕文本对齐两大痛点全部改善✨:识别结果按每句字数智能断句,SRT 字幕与时间线文本精准对齐,导入达芬奇后即可直接使用,大幅减少手工调整工作量。
功能特性
- 多语种识别:支持语言自动检测,无需手动指定;
- STT 模型驱动:本地语音识别,素材不出机;
- 大模型后处理:识别结果智能润色与断句优化;
- Windows 全适配:与达芬奇 Workspace 脚本体系无缝集成,一键导入 subtitle 轨道。
感恩开源,免费公开
感恩春星开讲的开源分享📖。我们同步向上游对齐,改良版插件免费公开,欢迎下载使用,一起共建剪辑行业良性生态💪
后续规划
对于低配电脑跑不动本地模型的用户,我们后续会推出云端计算方式。这部分收费不会高,且会是买断制,一次付费终身使用。
同时我们还会持续优化字幕修改方案,对标剪映的交互体验,让字幕的二次编辑更高效。
本文采用 CC BY-NC-SA 4.0 协议发布